
Partie 3 sur 4 – Protection dynamique : quand les contrôles évoluent avec les risques
Pourquoi les équipes chargées de la gestion des risques internes et de la protection des données collaborent, et pourquoi une vision complète du cycle de vie des risques utilisateur change notre conception d'une protection efficace
Le moyen le plus rapide de faire perdre confiance dans un programme de protection des données est de bloquer une action dont l'entreprise avait besoin. Tous ceux qui ont piloté un programme DLP connaissent le scénario : une règle se déclenche sur un transfert légitime, une exception est créée et, après suffisamment de faux positifs, les politiques finissent par passer en mode surveillance uniquement. Une protection qui n'est pas adaptée au contexte ne protège pas grand-chose.
La partie 1 nous a donné un langage commun grâce à l'Insider Threat Matrix™. La partie 2 nous a apporté la chaîne de preuves, avec l'analyse du ressenti permettant d'identifier les facteurs de motivation avant même que les données ne commencent à circuler. La partie 3 pose la question suivante : que pouvons-nous faire de ce contexte avant qu'un incident ne se produise ?
Voilà en quoi consiste une protection dynamique. La visibilité et les contrôles s'adaptent aux risques que vous pouvez réellement observer, s'appliquent là où ils sont nécessaires, ne perturbent pas le travail des autres utilisateurs et se désactivent automatiquement une fois le risque écarté.
Les règles statiques ont un problème de contexte
Les solutions DLP traditionnelles posent la question suivante : ces données doivent-elles aller à cet endroit ? Ces contrôles restent indispensables, car ils permettent de détecter les fuites accidentelles de données et posent les bases. Les risques internes soulèvent une deuxième question : cette personne devrait-elle effectuer cette action, à ce moment précis ?
Prenons l'exemple d'un commercial qui exporte 2 000 dossiers client dans le cadre d'un changement de secteur commercial approuvé. C'est parfaitement normal. Imaginons maintenant qu'un deuxième commercial effectue exactement la même exportation. Depuis plusieurs semaines, il échange avec un concurrent, a indiqué à un collègue qu'il comptait partir et a demandé à un assistant d'IA de reformuler une lettre de démission. Les RH n'en savent rien. Aucune démission n'a été officiellement annoncée. Puis les dossiers sont exportés.
Le contenu n'a pas changé. Le contexte, lui, a changé – plusieurs semaines avant même qu'un signalement officiel de départ n'existe. Une règle statique ne peut que bloquer les deux personnes ou autoriser les deux. Aucune de ces options n'est satisfaisante.
La gestion des risques internes et la protection des données se rejoignent
La protection des données et la gestion des risques internes devraient-ils devenir la responsabilité d'une même équipe ? Je m'intéresse moins à l'organigramme qu'au fonctionnement conjoint des politiques, car les deux équipes finissent par examiner la même chose : des données qui se déplacent vers un endroit où elles ne devraient pas aller. La DLP est l'outil utilisé par l'équipe chargée de la protection des données pour contrôler ces mouvements. Les risques internes ajoutent le contexte lié à la personne, à son comportement et au moment où l'action se produit.
En pratique, les deux équipes travaillent sur les mêmes événements de sortie de données, mais sous des angles différents. Le tri DLP traite l'alerte avec suffisamment de contexte pour l'écarter ou la faire remonter. L'équipe chargée de la gestion des risques internes mène des investigations proactives sur ces mêmes événements, mais dans un ensemble de données plus large : contexte des risques utilisateur, historique comportemental et signaux issus de l'analyse du ressenti. Cette vision devient particulièrement importante lorsque les règles atteignent leurs limites et qu'un utilisateur malveillant adopte une méthode que les contrôles n'avaient pas anticipée. Tout ce qui relève du périmètre de la DLP revient à cette équipe. Les deux équipes se rejoignent au niveau des mêmes éléments de preuve, au lieu de travailler chacune avec une vision partielle.
Cela ne fonctionne que si les deux équipes s'appuient sur la même source. C'est pourquoi l'architecture technique compte davantage que la structure hiérarchique. Trois capacités permettent de concrétiser cette approche.
- Un seul agent, suffisamment flexible pour les deux programmes. Un agent d'endpoint unique capture les données télémétriques liées aux mouvements de fichiers dont l'équipe chargée de la protection des données a besoin pour la DLP et, lorsqu'un déclencheur est activé, fournit également la profondeur comportementale et l'investigation numérique nécessaires au traitement des risques internes. Pas deux agents qui se disputent les ressources du même endpoint et produisent deux versions du même événement. Un déploiement, un flux de données, une chronologie.
- Un accès limité au périmètre de chaque programme, appliqué par une politique. Chaque programme définit son périmètre, et des politiques d'accès basées sur les rôles veillent à son respect. L'événement n'existe qu'une seule fois, mais l'analyste de la DLP voit ce que le périmètre de la DLP l'autorise à voir, tandis que l'analyste des risques internes voit ce que le périmètre de son programme et les obligations en matière de confidentialité l'autorisent à consulter. Le périmètre est protégé par une politique, pas par la confiance.
- Des décisions de protection tenant compte du comportement. Puisque la politique DLP et le contexte des risques utilisateur reposent sur le même agent, la décision de protection peut prendre en compte les deux au moment où l'action se produit : quelle est la nature du contenu, où est-il envoyé et cette personne, à cet instant précis, justifie-t-elle un avertissement, un délai ou un blocage ?
Cette approche fonctionne parce qu'aucune équipe n'a besoin de renoncer à quoi que ce soit. Chaque équipe conserve son propre workflow et son propre périmètre, mais les preuves ne sont pas fragmentées. Une alerte DLP transmise à l'équipe chargée de la gestion des risques internes arrive avec son contexte, plutôt que sous la forme d'un simple numéro de ticket. L'entreprise peut ainsi démontrer, politique par politique, qui a eu accès à quoi et pour quelle raison.
Pensez échelle, pas interrupteur
Une protection dynamique ne consiste pas à passer directement d'une autorisation à un blocage. C'est une échelle, avec un niveau de base.
Le niveau de base correspond à la politique appliquée à tous : une visibilité légère sur les mouvements de fichiers et les sorties de données, ainsi que des contrôles réglementaires qui restent toujours actifs. Il ne s'agit volontairement pas d'une collecte exhaustive, car la plupart des utilisateurs, la plupart du temps, ne la justifient pas.
Le premier niveau consiste en une surveillance renforcée : le travail continue, mais le programme accorde davantage d'attention aux activités. Viennent ensuite les contrôles légers : un avertissement, une demande de justification, un court délai ou une redirection vers une application approuvée. Au niveau supérieur se trouvent les contrôles bloquants, pour les situations dans lesquelles le niveau de confiance et l'impact potentiel justifient d'empêcher l'action.
Les données comptent également. Les classificateurs pilotés par l'IA permettent d'identifier du code source là où la simple correspondance de modèles atteint ses limites. Coller du code dans un outil d'IA peut être une pratique courante pour un développeur. Mais si cette action est associée à un niveau de risque utilisateur élevé ou à des comportements correspondant à une phase de préparation, elle peut justifier une réponse différente. Comprenez les données, comprenez la personne, appliquez le niveau de friction adapté.
Surveillance renforcée : davantage de profondeur lorsque c'est nécessaire, pas en permanence
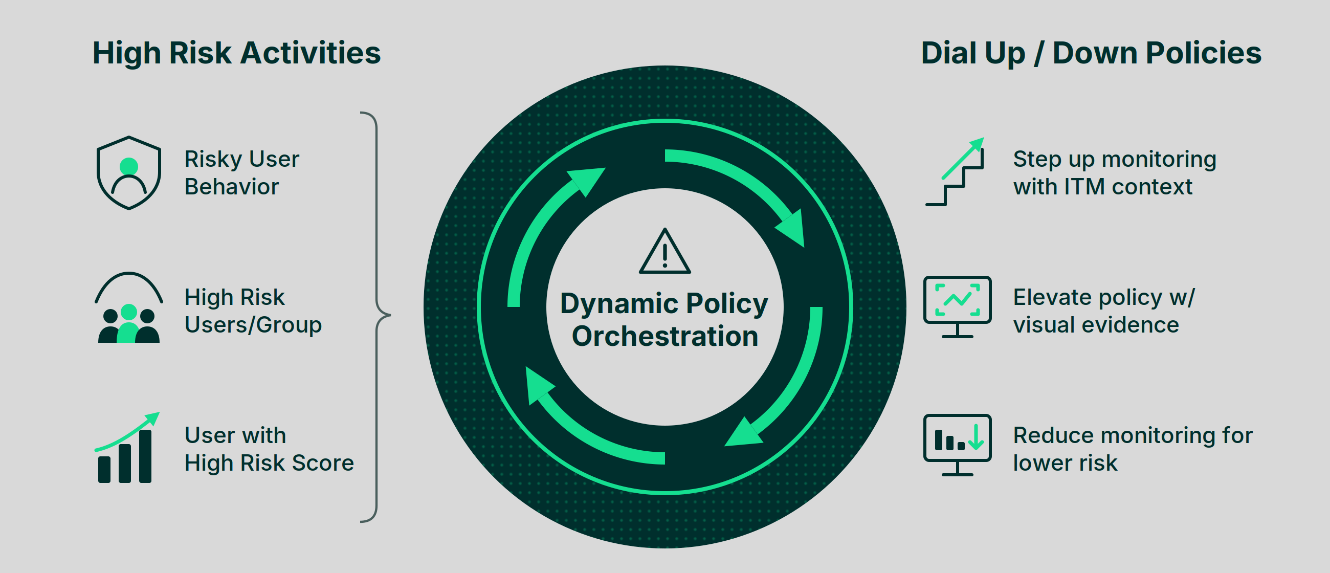
La surveillance renforcée est déclenchée par des événements précis, limitée dans le temps et automatiquement désactivée. Un déclencheur défini dans la politique de l'entreprise fait passer un utilisateur de la politique standard de suivi des mouvements de fichiers à un niveau de collecte plus approfondi pendant une durée déterminée. Pendant cette période, les événements sont enrichis de détails d'investigation numérique sur le fichier et sa traçabilité, des activités environnantes sur les endpoints et dans le cloud, ainsi que de captures d'écran des moments pertinents. À la fin de cette période, si aucun nouvel élément n'est apparu, l'utilisateur revient automatiquement au niveau de base. Personne n'a besoin de le retirer manuellement d'une liste de surveillance.
Les déclencheurs proviennent de deux sources : les risques et le comportement utilisateur (hausse soudaine des téléchargements, premier transfert vers une destination non autorisée, avertissement ignoré, dépassement d'un seuil de score de risque), ainsi que le groupe d'utilisateurs et le cycle de vie (nouvelles recrues pendant leurs premières semaines, collaborateurs ayant annoncé leur départ entre la démission et le départ effectif, prestataires approchant de la fin de leur contrat, changements de poste ou personnes faisant l'objet d'une procédure RH). Élever le niveau de surveillance d'un groupe relève d'une décision sur les politiques, et non d'un jugement porté sur un individu.
Cette approche contribue à protéger la vie privée et à éviter une collecte excessive. Les captures d'écran généralisées sont difficiles à justifier auprès des collaborateurs, des représentants du personnel ou des autorités de contrôle, et la plupart des captures ne sont de toute façon jamais consultées. En associant la collecte à des comportements définis par une politique, le programme peut expliquer pourquoi une personne a été placée sous surveillance renforcée, pendant combien de temps et quelles données ont été collectées. Les captures d'écran existent parce qu'un déclencheur documenté s'est activé, et non parce que quelqu'un était curieux.
Le retour automatique au niveau de base permet de maintenir un périmètre de surveillance maîtrisé.
Les mêmes déclencheurs pilotent les contrôles. Ce qui fait passer un utilisateur en surveillance renforcée peut également activer un contrôle léger lors de son prochain mouvement de données et, si les éléments de preuve s'accumulent, conduire à un blocage. La surveillance et la protection s'appuient sur une même chaîne de preuves ; elles restent ainsi alignées.
C'est là que la partie 2 prend tout son sens : les signaux de motivation et de préparation sont souvent ceux qui déclenchent le passage en surveillance renforcée. Les preuves s'accumulent donc alors qu'il est encore temps d'agir. L'utilisateur n'est pas désigné comme une menace – le programme lui accorde simplement davantage d'attention pendant une période définie et pour une raison précise.
La friction légère peut révéler ce qu'un blocage ne permettrait pas de voir
Un avertissement ne se contente pas d'interrompre une action. Il crée des preuves. Quelqu'un tente de transférer des données sensibles vers une destination qui ne devrait pas les recevoir et un avertissement s'affiche. Peut-être réalise-t-il son erreur et s'arrête-t-il. Peut-être justifie-t-il son action et poursuit-il via un workflow approuvé. Peut-être tente-t-il de contourner le contrôle. La première action pouvait être le résultat d'une négligence. Ce qui se passe ensuite est beaucoup plus révélateur.
Dans le respect de seuils définis, et lorsque les données et l'impact le permettent, vous pouvez laisser la situation évoluer : la friction protège contre le risque immédiat tout en permettant d'observer la suite. Bloquer immédiatement la première action suspecte peut faire disparaître le contexte dont les enquêteurs ont besoin. Cela ne signifie pas qu'il faut laisser une activité dangereuse se poursuivre : les données stratégiques ou une violation présentant un niveau de confiance élevé doivent toujours faire l'objet d'un blocage immédiat, conformément aux seuils définis avec les RH et l'équipe juridique. Parfois, la bonne protection est un mur ; parfois, c'est un ralentisseur qui vous permet également de comprendre ce que quelqu'un cherche à faire.
Suivi de l'évolution sur l'échelle : un cas, cinq jours
Jake, ingénieur logiciel, annonce sa démission un lundi avec un préavis de deux semaines. Le système RH signale un événement déclencheur connu associé à un départ, et la plate-forme le fait passer au niveau supérieur : celui de la surveillance renforcée pendant la durée de son préavis. Ses accès ne changent pas ; ses événements sont simplement collectés avec davantage de profondeur.
Le mercredi, son volume de téléchargements augmente fortement par rapport à son niveau habituel. Associée à sa démission, cette hausse élargit le périmètre de surveillance : davantage d'activités sur les endpoints et dans le cloud sont collectées, notamment des captures d'écran autour des transferts signalés, afin qu'un analyste puisse voir ce qui a été extrait et où les données ont été envoyées.
Le vendredi, Jake colle du code source dans un outil d'IA. Habituellement, ce serait une action de routine, mais pas pour son profil de risque actuel. Un contrôle léger lui demande de justifier cette action. Jake ferme l'avertissement, change de navigateur et réessaie.
C'est cette tentative de contournement, et non le simple fait d'avoir collé du code, qui change la donne. Contourner un avertissement semble intentionnel : le score de risque augmente, l'accès aux référentiels est élargi pour permettre une analyse, et les tentatives suivantes d'exfiltration de code source sont bloquées. Aucun événement pris isolément – démission, hausse des téléchargements ou collage de code – ne justifiait à lui seul un blocage. Pris ensemble, ils racontent une histoire différente.
Imaginons maintenant l'autre scénario. La hausse des téléchargements du mercredi correspond à une transmission de fichiers autorisée. Le vendredi se déroule normalement et aucune alerte n'est déclenchée. La période de surveillance de Jake prend fin avec son préavis, la collecte renforcée s'arrête et il quitte l'entreprise avec un niveau de surveillance revenu à la normale, sans qu'aucune intervention ne soit nécessaire. C'est aussi cela, le fonctionnement de l'échelle.
L'objectif n'est pas de bloquer davantage, mais de protéger avec davantage de précision.
Une « protection dynamique » peut donner l'impression qu'il s'agit d'une excuse pour appliquer des contrôles toujours plus agressifs. Elle devrait produire l'effet inverse : moins de friction pour la majorité des utilisateurs, et une friction plus ciblée lorsque les preuves la justifient. Un contrôle appliqué de manière ciblée est beaucoup plus facile à accepter qu'une nouvelle politique globale qui bloque des activités légitimes jusqu'à ce que tout le monde réclame des exceptions.
Cette précision nécessite une gouvernance, car des preuves plus riches impliquent également davantage de responsabilités. Les RH et l'équipe juridique doivent s'accorder sur les éléments qui font passer un utilisateur à un niveau de risque supérieur, la durée de cette élévation, les données collectées à chaque niveau et les actions autorisées. Les seuils sont définis, les contrôles sont auditables, les captures d'écran restent masquées jusqu'au niveau d'escalade approprié et les accès sont régis par les politiques propres à chaque programme décrites précédemment.
La DLP ne disparaît pas. Elle gagne le contexte qui lui faisait défaut, de sorte que les contrôles les plus stricts ne s'appliquent que lorsqu'ils sont justifiés – une approche plus pragmatique que l'ajout de nouvelles règles.
À suivre : identifier les risques que vous ne connaissez pas encore
La partie 1 nous a donné le langage commun. La partie 2 nous a apporté la chaîne de preuves, avec l'analyse du ressenti permettant d'identifier les facteurs de motivation. La partie 3 a montré comment ces preuves permettent à la protection de s'adapter à l'évolution des risques.
Il reste un élément : que se passe-t-il lorsque le système peut commencer à détecter, à analyser et à constituer le dossier à votre place ?
La partie 4 couvre le tri et les investigations agentiques de bout en bout : connecter les signaux sur l'ensemble du cycle de vie afin d'identifier les risques internes émergents et d'indiquer aux analystes où chercher, plutôt que de dépendre uniquement d'un signalement souvent réactif. Le besoin est simple : exploiter toutes ces données riches pour travailler plus intelligemment et identifier plus rapidement les risques, car la plupart des équipes ne voient pas leurs effectifs augmenter ; au mieux, leurs ressources restent stables et, avec l'adoption de l'IA, elles sont souvent en diminution.
En savoir plus
Regardez notre récent webinaire avec les cofondateurs de l'Insider Threat Matrix, James Weston et Joshua Beaman.