
Parte 3 di 4: Protezione dinamica: quando i controlli evolvono con i rischi
Perché i team incaricati della gestione dei rischi interni e della protezione dei dati collaborano e perché una visione completa dell'intero ciclo di vita del rischio utente cambia la nostra concezione di una protezione efficace.
Il modo più rapido per far perdere la fiducia in un programma di protezione dei dati è bloccare un’azione di cui l'azienda aveva bisogno. Chiunque abbia gestito un programma DLP conosce bene lo scenario: una regola si attiva su un trasferimento legittimo, viene generata un'eccezione e, dopo un numero sufficiente di falsi positivi, le policy finiscono per passare alla modalità solo monitoraggio. Una protezione che non è adattata al contesto non protegge nulla a lungo.
La parte 1 ci ha fornito un linguaggio condiviso grazie all’Insider Threat Matrix™. La parte 2 ci ha fornito la catena delle prove, con l'analisi del sentimento che permette di identificare i fattori motivazionali prima ancora che i dati inizino a circolare. La parte 3 pone la seguente domanda: cosa possiamo fare con quel contesto prima che si verifichi un incidente?
Ecco in cosa consiste una protezione dinamica. La visibilità e i controlli si adattano ai rischi che puoi effettivamente osservare, vengono applicati dove necessario, non interferiscono con il lavoro di altri utenti e si disattivano automaticamente una volta eliminato il rischio.
Le regole statiche hanno un problema di contesto
Le soluzioni DLP tradizionali pongono la seguente domanda: questi dati dovrebbero andare in quel posto? Questi controlli rimangono essenziali, perché permettono di rilevare le perdite accidentali e pongono le basi. I rischi interni pongono una seconda domanda: questa persona dovrebbe effettuare questa azione, in questo preciso momento?
Prendiamo l’esempio di un commerciale che esporta 2.000 record di clienti nell’ambito di un cambio di settore commerciale approvato. Questo è assolutamente normale. Immaginiamo ora che un secondo commerciale esegue esattamente la stessa esportazione. Da diverse settimane è in contatto con un concorrente, ha detto a un collega che intendeva andarsene e ha chiesto a un assistente di IA di riformulare una lettera di dimissioni. Le risorse umane non ne sono al corrente. Non è stato dato alcun preavviso di dimissioni. Poi i record vengono esportati.
Il contenuto non è cambiato. Il contesto invece, è cambiato, settimane prima che venisse emesso una segnalazione formale di dimissione. Una regola statica può bloccare entrambe le persone oppure autorizzarle entrambe. Nessuna di queste opzioni è soddisfacente.
La gestione dei rischi interni e la protezione dei dati convergono
La protezione dei dati e la gestione dei rischi interni dovrebbero diventare responsabilità di uno stesso team? Mi interessa meno l'organigramma rispetto al funzionamento congiunto delle policy, poiché entrambi i due team finiscono per monitorare la stessa cosa: dati che si spostano verso un posto in cui non dovrebbero andare. La DLP è lo strumento utilizzato dai team incaricati della protezione dei dati per controllare tali movimenti. I rischi interni aggiungono il contesto legato alla persona, al suo comportamento e al momento in cui si verifica l’azione.
In pratica, i due team lavorano sugli stessi eventi di uscita, ma da due angolazioni diverse. Il triage DLP tratta l'allarme fornendo un contesto sufficiente per escluderlo o farlo scalare. Il team incaricato della gestione dei rischi interni conduce indagini proattive su quegli stessi eventi, in un set di dati più ampio: contesto dei rischi utente, cronologia comportamentale e segnali derivanti dall’analisi del sentimento. Questa visione assume particolare importanza quando le regole raggiungono i propri limiti e un utente malintenzionato adotta una tattica che i controlli non avevano previsto. Tutto ciò che rientra nell’ambito della DLP viene ricondotto a quel team. I due team convergono sugli stessi elementi di prova, anziché lavorare ciascuno con una visione parziale.
Funziona solo se entrambi i team attingono dalla stessa fonte, motivo per cui l’architettura tecnica conta più della struttura gerarchica. Tre funzionalità permettono di concretizzare questo approccio.
- Un solo agente, sufficientemente flessibile per entrambi i programmi. Un singolo agente endpoint acquisisce i dati di telemetria legati agli spostamenti dei file di cui il team incaricato della protezione dei dati ha bisogno per la DLP e, quando viene attivato un fattore scatenante, fornisce anche la profondità comportamentale e l’indagine forense necessaria per gestire i rischi interni. Non due agenti che si contendono le risorse dello stesso endpoint e producono due versioni dello stesso evento. Un’implementazione, un flusso di dati, una sequenza temporale.
- Un accesso limitato all’ambito di ogni programma, applicato da una policy. Ogni programma definisce il suo ambito, e le policy di accesso basate sui ruoli ne garantiscono il rispetto. L'evento esiste una sola volta, ma l’analista della DLP vede cosa l’ambito della DLP gli consente di vedere, mentre l’analista dei rischi interni vede ciò che l’ambito del suo programma e gli obblighi in materia di privacy gli consentono di consultare. L’ambito è protetto da una policy, non dalla fiducia.
- Decisioni di protezione che tengono conto del comportamento. Poiché la policy DLP e il contesto dei rischi utente si basano sullo stesso agente, la decisione di protezione può tenere conto di entrambi nel momento in cui si verifica l'azione: qual è la natura del contenuto, dove viene inviato e, in quell’istante preciso, questa persona giustifica un avviso, un ritardo o un blocco?
Questo approccio funziona perché nessun team deve rinunciare a nulla. Ogni team conserva il suo flusso di lavoro e il proprio ambito, ma le prove non sono frammentate. Un allarme DLP trasmette al team incaricato della gestione dei rischi interni arriva con il suo contesto, piuttosto che sotto forma di un semplice numero di ticket. L’azienda può così dimostrare, policy per policy, chi ha visto cosa e per quale motivo.
Pensa alla scala, non all'interruttore
Una protezione dinamica non consiste nel passare direttamente da un’autorizzazione a un blocco. È una scala, con un piano terra.
Il piano terra corrisponde alla policy applicata a tutti: una visibilità leggera sui movimenti dei file e le uscite di dati, oltre a controlli regolamentari che restano sempre attivi. Non si tratta deliberatamente di una raccolta esaustiva, poiché la maggior parte degli utenti, nella maggior parte dei casi, non la giustifica.
Il primo gradino consiste in un monitoraggio rafforzato: il lavoro continua, ma il programma presta maggiore attenzione alle attività. Quindi seguono i controlli leggeri: un avviso, una richiesta di giustificazione, un breve ritardo o un reindirizzamento verso un'applicazione approvata. Nella livello superiore si trovano i controlli bloccanti, per le situazioni in cui il livello di fiducia e l'impatto potenziale giustificano il blocco dell'azione.
Anche i dati sono importanti. I classificatori guidati dall’IA permettono di identificare il codice sorgente laddove la semplice corrispondenza dei pattern raggiunge i propri limiti. Incollare un codice in uno strumento di IA è una pratica abituale per uno sviluppatore. Ma se questa azione è associata a un livello di rischio utente elevato o a comportamenti corrispondenti a una fase di preparazione, può giustificare una risposta diversa. Comprendi i dati, comprendi la persona, applica il giusto livello di attrito.
Monitoraggio rafforzato: maggior profondità quando è necessario, non sempre
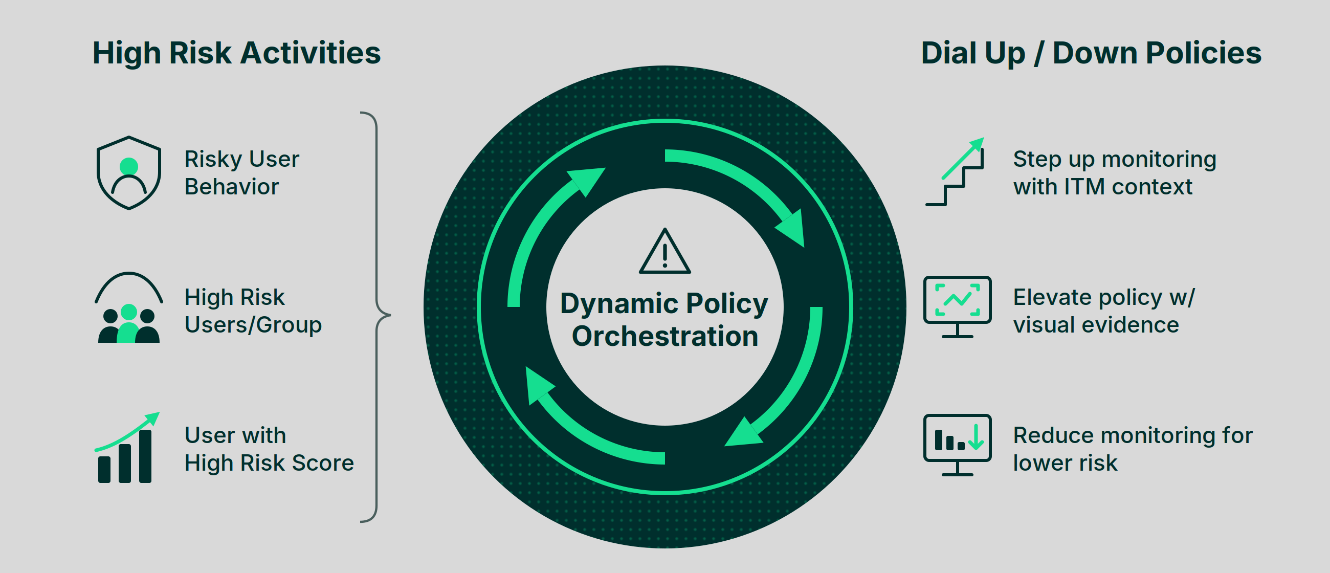
Il monitoraggio rafforzato viene attivato da eventi precisi, limitato nel tempo e disattivato automaticamente. Un fattore scatenante definito nella policy dell’azienda fa passare un utente dalla policy di base di monitoraggio dei movimenti dei file a un livello di raccolta dati più approfondito per un periodo di tempo stabilito. Durante tale periodo, gli eventi vengono arricchiti di dettagli forensi relativi al file e alla sua tracciabilità, con le attività circostanti sugli endpoint e nel cloud, nonché con schermate dei momenti rilevanti. Alla fine di questo periodo, se non è apparso alcun nuovo elemento, l’utente torna automaticamente al livello di base. Nessuno deve rimuoverlo da un elenco di sorveglianza.
I fattori scatenanti provengono da due fonti: i rischi e il comportamento utente (aumento improvviso dei download, primo caricamento verso una destinazione non approvata, un avviso ignorato, superamento di una soglia di rischio) nonché il gruppo di utenti e il loro ciclo di vita (nuovi assunti nelle prime settimane, collaboratori che hanno annunciato le proprie dimissioni tra la comunicazione all’effettiva uscita dall’azienda, collaboratori prossimi alla scadenza del contratto, cambi di ruolo o persone oggetto di un procedimento delle risorse umane). Aumentare il livello di monitoraggio di un gruppo è una decisione di policy, non un giudizio espresso nei confronti di un individuo.
Questo approccio contribuisce a proteggere la privacy e a evitare una raccolta eccessiva. Le schermate generalizzate sono difficili da giustificare nei confronti dei collaboratori, dei rappresentanti dei lavoratori o delle autorità di regolamentazione e la maggior parte di essi non viene mai consultata. Associando la raccolta a comportamenti definiti da una policy, il programma può spiegare perché una persona è stata messa sotto monitoraggio rafforzato, per quanto tempo e quali dati sono stati acquisiti. Gli screenshot esistono perché è stato attivato un fattore scatenante documentato, non perché qualcuno fosse curioso.
Il ritorno automatico al livello di base consente di mantenere un ambito di monitoraggio controllato.
Gli stessi fattori scatenanti attivano i controlli. Ciò che fa passare un utente a un livello di monitoraggio rafforzato può anche attivare un controllo leggero sul suo prossimo movimento dei dati e, se gli elementi di prova si accumulano, determinare un blocco. Il monitoraggio e la protezione attingono alla medesima catena di prove, così da rimanere sempre allineati.
È qui che la parte 2 assume il suo significato: i segnali di motivazione e preparazione sono spesso quelli che fanno scattare il passaggio a un livello di monitoraggio rafforzato. Le prove si accumulano quindi quando c’è ancora tempo per agire. L’utente non viene segnalato come una minaccia; il programma semplicemente gli presta maggiore attenzione, per un periodo definito e un motivo preciso.
La frizione leggera può rivelare qualcosa che un blocco non permette di vedere
Un avvertimento non interrompe semplicemente un'azione. Crea prove. Qualcuno tenta di caricare dati sensibili verso una destinazione che non dovrebbe riceverli e viene visualizzato un avviso. Forse si rende conto dell'errore e si ferma. Forse giustifica la propria azione e procede attraverso un flusso di lavoro approvato. Forse cerca di aggirare il controllo. La prima azione potrebbe essere il risultata di una negligenza. Ciò che accade successivamente rivela molto di più.
Nel rispetto di soglie definite e laddove i dati e l'impatto lo consentano, puoi lasciar evolvere la situazione: la frizione protegge dal rischio immediato permettendo di osservare ciò che accade successivamente. Il blocco immediato della prima azione sospetta può cancellare il contesto di cui gli investigatori hanno bisogno. Ciò non significa che si debba permettere che un’attività pericolosa prosegua: i dati strategici o una violazione che presenta un elevato livello di fiducia devono sempre essere oggetto di un blocco immediato, secondo soglie definite in accordo con le risorse umane e l'ufficio legale. Talvolta, la protezione adeguata assume la forma di un muro, mentre in altri casi è un rallentatore che permette comunque di comprendere ciò che qualcuno cerca di fare.
Monitoraggio dell’evoluzione sulla scala: un caso, cinque giorni
Jake, ingegnere software, annuncia le sue dimissioni un lunedì con un preavviso di due settimane. Il sistema delle risorse umane segnala un evento scatenante noto associato a un’uscita dall’azienda e la piattaforma lo fa passare al livello superiore, ovvero quello del monitoraggio rafforzato per il periodo di preavviso. Il suo accesso non cambia; i suoi eventi vengono semplicemente acquisiti con maggior approfondimento.
Mercoledì, il suo volume di download sale ben al di sopra del suo livello abituale. In combinazione con le dimissioni, questo evento amplia il perimetro di monitoraggio: vengono acquisite più attività sugli endpoint e nel cloud, comprese le schermate relative ai trasferimenti segnalati, in modo che un analista possa vedere cosa è stato estratto e dove sono stati inviati i dati.
Venerdì, Jake incolla del codice sorgente in uno strumento di IA. Normalmente, sarebbe un’azione di routine, ma non per il suo attuale profilo di rischio. Un controllo leggero gli richiede di giustificare tale azione. Jake chiude l'avviso, cambia browser e riprova.
Questo tentativo di elusione, e non l'azione di aver incollato il codice, cambia tutto. Eludere un avviso sembra intenzionale: il punteggio di rischio aumenta, l'accesso ai repository viene esteso per consentire l’analisi e i tentativi seguenti di sottrarre il codice sorgente vengono bloccati. Nessun momento preso singolarmente (dimissioni, picco di download, incollaggio del codice) giustificava di per sé un blocco. Insieme, raccontano una storia diversa.
Ora immaginiamo l'altro scenario. Il picco di download di mercoledì rappresenta un trasferimento di file autorizzato, mentre il venerdì procede tranquillamente, senza che alcun avviso si attivi. Il periodo di monitoraggio di Jake scade con il suo preavviso, la raccolta si interrompe e lui lascia l’azienda con un livello di monitoraggio normale, senza che sia richiesto alcun intervento. Anche questo è il funzionamento della scala.
L'obiettivo non è bloccare di più, ma proteggere con maggior precisione.
La «protezione dinamica» può sembrare una scusa per controlli sempre più aggressivi. Dovrebbe essere il contrario: meno attrito per la maggior parte degli utenti, un attrito più mirato laddove le prove lo giustificano. Un controllo applicato in modo mirato è molto più gestibile rispetto a una nuova policy globale che blocca attività legittime finché tutti richiedono un'eccezione.
Tale precisione richiede una governance, perché prove più ricche comportano maggiori responsabilità. Le risorse umane e l’ufficio legale devono accordarsi su cosa determina l'incremento di un livello di rischio per u utente, la durata di tale stato, i dati raccolti a ciascun livello e le azioni autorizzate. Le soglie sono definite, i controlli sono verificabili, le schermate acquisite rimangono mascherate fino al livello di escalation appropriato e gli accessi sono regolati dalle policy specifiche di ciascun programma sopra descritte.
La DLP non scompare. Ottiene il contesto che non ha mai avuto, pertanto i controlli più rigorosi si applicano solo dove sono giustificati, un approccio più pragmatico rispetto all'introduzione di nuove regole.
Passo successivo: identificare i rischi che ancora non conosci
La parte 1 ci ha fornito il linguaggio comune. La parte 2 ci ha fornito la catena delle prove, con l'analisi del sentimento che ha permesso di identificare i fattori motivanti. La parte 3 ha mostrato come tali prove consentano alla protezione di adattarsi all’evoluzione dei rischi.
Rimane un aspetto: cosa accade quando il sistema può iniziare a rilevare, analizzare e creare il caso per l’utente?
La parte 4 illustra il triage e le indagini agentiche end-to-end: collegare i segnali lungo l'intero ciclo di vita per identificare i rischi interni emergente e indicare agli analisti dove cercare, anziché affidarsi esclusivamente a un sistema di segnalazione, spesso reattivo. La necessità è semplice: utilizzare tutti questi dati ricchi per lavorare in modo più intelligente e identificare i rischi più rapidamente, poiché la maggior parte dei team non dispone di ulteriore personale; le risorse sono, nella migliore delle ipotesi, stabili e spesso, con l’adozione dell’IA, si riducono.
Per saperne di più
Guarda il nostro recente webinar con i cofondatori dell’Insider Threat Matrix, James Weston e Joshua Beaman.